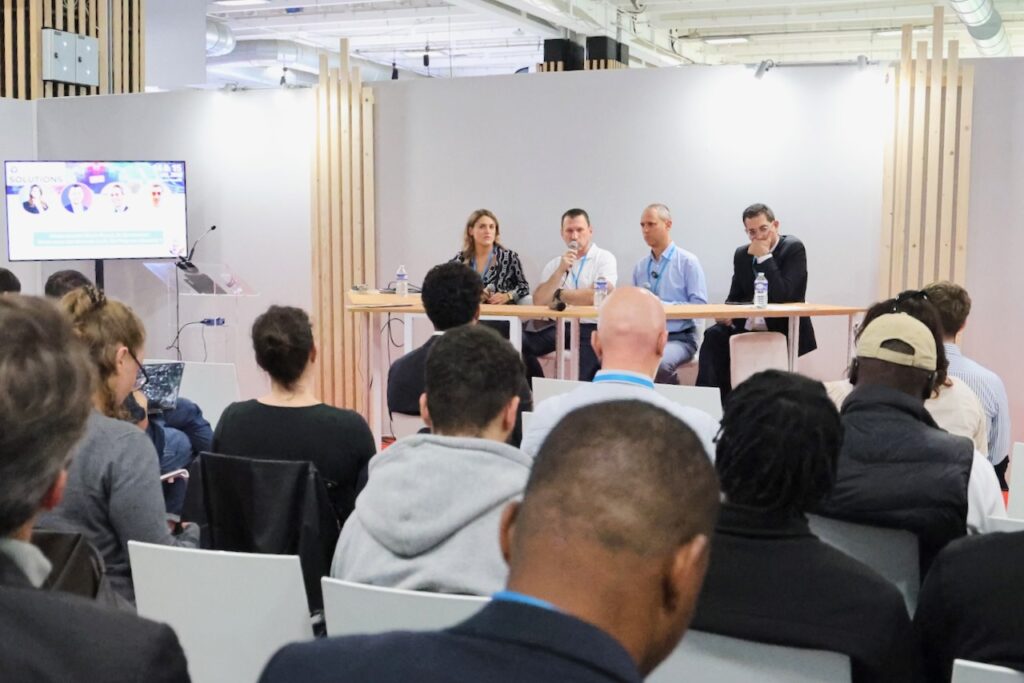
Faut-il opter pour des services SaaS, une plateforme sur site ou managée par un prestataire ? Ce choix cornélien a été examiné mi-octobre par quatre professionnels réunis autour d’une table ronde du forum Cybersécurité-IA du salon Tech Solutions.
Les professionnels qui parlent le mieux de l’IA sont ceux qui l’implémente, forment les métiers, et contribuent à la faire évoluer, pas les pseudo-experts clamant ce que l’IA s’apprête à faire pour votre entreprise.
La vraie question du moment serait plutôt : Où l’IA doit-elle traiter nos données et stocker les résultats tandis que les éditeurs, infogérants, intégrateurs et prestataires cloud voudraient tous les héberger ?
C’était l’angle proposé à Marine Capron (Directrice Adjointe Cybersécurité et Technologie de Magellan), Julien Ciullo (CTO de Scafe), Giuliano Ippoliti (Directeur Cybersécurité de Cloud Temple) et Bertrand Ounanian (Systems Engineering Manager de Vast Data) au beau milieu du cybermois. Leurs réponses ne tiennent pas en un slogan.
Adopter n’est pas former, ni transformer
Premier constat, peu flatteur : l’IA est adoptée rapidement par les utilisateurs, moins vite rentabilisée. Il convient de distinguer automatisation et agentisation, de prioriser les cas d’usage et de lancer des prototypes. Les gains réels n’arrivent qu’avec l’industrialisation. D’où le casse-tête actuel du DSI : prouver le retour sur investissement, sans négliger l’acculturation des équipes IT et métiers. L’IA de confiance commence par des humains bien formés.
Le choix d’infrastructure dépend non seulement du coût, des compétences et des réseaux déjà en place mais surtout de la tolérance aux pannes que les métiers doivent fixer : une IA indisponible de 13:00 à 19:00 est-elle encore acceptable par tous ?
Pour Giuliano Ippoliti, disponibilité et intégrité sont des prérequis à gérer avant l’implémentation : « Ce qui pose problème à présent, c’est la confidentialité des données. »
Surtout face aux lois extraterritoriales. Les données sensibles sont donc orientées vers un cloud privé ou public souverain. Dans les faits, on retient une infrastructure souveraine pour le cœur de métier, on flèche des données de santé vers un hébergeur certifié HDS, tandis que le cloud public peut accueillir d’autres services, aux données anonymisées le cas échéants.
Anticiper la rupture de services
Bertrand Ounanian rappelle que « l’IA consomme et produit encore plus de données que le Big Data ne le faisait ». D’où l’enjeu de pouvoir déplacer ses workloads d’un environnement à l’autre, ce qui n’est jamais trivial.
Un fournisseur lointain peut couper le service à tout moment. C’est le fameux kill switch. Du coup, la réversibilité doit s’inviter au cahier des charges. Et toute responsabilité se contractualise : clauses de sortie, matrice de responsabilités, chiffrage précis de la sortie du cloud s’imposent dorénavant.
Côté technique : le recours aux standards ouverts, applications virtualisées ou conteneurisées et copies de données Air Gap sont de rigueur. Les plans de reprise et de continuité d’activités remontent dans les priorités des ETI et des grands comptes. Un acteur financier soumis au règlement Dora (Digital Operational Resilience Act) a ainsi bâti son infrastructure sur deux clouds capables de se relayer.
L’IA de confiance facilite le contrôle
Livrer un document à un chatbot grand public, c’est le partager. Pour un appel d’offres ou des données de santé, mieux vaut éviter cette pratique trop courante. Suite à ce rappel, les solutions envisagées par le panel vont du modèle linguistique hébergé chez un acteur souverain au déploiement de serveur d’inférence chez soi, jusqu’au RAG auto-hébergé pour la base de connaissances et de savoir-faire.
Un LLM reste non déterministe, donc jamais parfaitement prévisible : moindre privilège, validation humaine, bacs à sable et journalisation restent de mise. Julien Ciullo met aussi en garde : « On parle beaucoup de fuite externe, mais il y a aussi un risque de fuite interne. » Une IA qui répond à tout le monde avec tous les documents en mémoire n’est plus un assistant, mais un bot indiscret.
Marine Capron résume la confiance en quatre piliers : la technique, l’humain (former massivement), l’éthique (RGPD, AI Act) et l’environnement pour éviter de brûler des tokens à chaque recherche sur un moteur en ligne.
A propos du kill switch, Giuliano Ippoliti confirme : « Le référentiel SecNumCloud 3.2 protège des lois extraterritoriales, grâce à ses exigences sur l’actionnariat« . Mais les logiciels d’infra (hyperviseur inclus) des prestataires ne sont pas toujours ouverts et auditables, signale un auditeur. Un autre a suggéré de s’en remettre aux normes et certifications telles que l’ISO 42001 pour la mise en place d’un système de gestion pour l’intelligence artificielle, et l’ISO 27090 pour la gouvernance de l’IA.
Le multi-cloud, une combinaison subie ou choisie ?
Fusions et acquisitions font parfois du multicloud un héritage plus qu’une stratégie de la DSI. La cartographie des actifs, une classification des données, des sauvegardes cloisonnées et des exercices de crise réalistes deviennent précieux. C’est ainsi qu’on peut mesurer la résilience, estime Marine Capron.
A l’horizon, des agents spécialisés collaboreront par milliers. Leur sécurité reste à inventer, mais une piste se dessine : elle consiste à les traiter comme des identités non humaines, avec les mêmes règles que des collaborateurs, à commencer par le moindre privilège. En résumé, l’infrastructure hybride domine, la donnée reste à classer avant d’être déplacée et la réversibilité se prévoit dès le contrat.